
El código heredado rara vez desaparece por sí solo. Los equipos posponen la eliminación porque temen que una dependencia oculta rompa la producción en el momento en que alguien elimine un archivo. Esta lista de verificación adopta un punto de vista diferente: la retirada funciona mejor como una serie de pasos pequeños y reversibles en lugar de una eliminación dramática. No necesita una reescritura completa para reducir el riesgo. Necesita comprobaciones claras antes, durante y después de la eliminación, y un plan de reversión (rollback) en el que realmente confíe.
Por qué el código heredado necesita un plan de retiro real
Primero, la mayoría de las fallas de código heredado aparecen semanas después de la eliminación, no durante ella. Una ruta de código poco común finalmente se ejecuta, un trabajo programado se activa, o un sistema asociado llama a un punto final que nadie recordó que existía. Cada sorpresa se convierte en una emergencia en producción, y las emergencias cuestan mucho más de lo que habría costado una lista de verificación cuidadosa.
Sin embargo, los equipos a menudo se saltan la etapa de planificación porque el código antiguo se siente aburrido en comparación con las nuevas funciones. Nadie quiere una reunión sobre un módulo de pago escrito hace una década. Sin embargo, saltarse esa reunión es exactamente cómo un riesgo pequeño se convierte en un incidente mayor. Retener sistemas heredados conlleva múltiples riesgos, incluidos el incumplimiento, los altos costos de mantenimiento y las vulnerabilidades de seguridad. Una revisión breve ahora cuesta mucho menos que una interrupción después.
La lista de comprobación previa a la eliminación para la limpieza de código heredado
Antes de borrar nada, comprueba tres cosas: quién llama a este código, quién posee los datos que toca y qué tan rápido puede retroceder el equipo si algo se rompe. Registrar el tráfico real durante un ciclo comercial completo muestra si un punto final supuestamente muerto todavía recibe solicitudes. Además, pregunta directamente a cada equipo descendente en lugar de confiar en un diagrama de arquitectura antiguo que nadie ha actualizado en años.
A continuación, escribe el plan de reversión antes de escribir el código de eliminación. Un plan de reversión convierte una eliminación arriesgada en un experimento reversible en lugar de un salto de fe. Por ejemplo, mantén la ruta antigua detrás de una bandera durante un periodo determinado en lugar de eliminarla directamente. Este simple hábito evita la mayoría de los incidentes de producción vinculados al trabajo de limpieza de código heredado.
Luego, añade alertas de monitorización, documentación actualizada y un propietario nombrado a la lista de comprobación. Construir una red de seguridad es lo que hace posible la refactorización de código heredado. Sin una, incluso un pequeño cambio puede crear errores inesperados o romper flujos de trabajo críticos. En consecuencia, todos en el equipo saben qué sucede si el tráfico reaparece en una ruta que se pensaba retirada.
Desplegar el cambio sin romper la producción
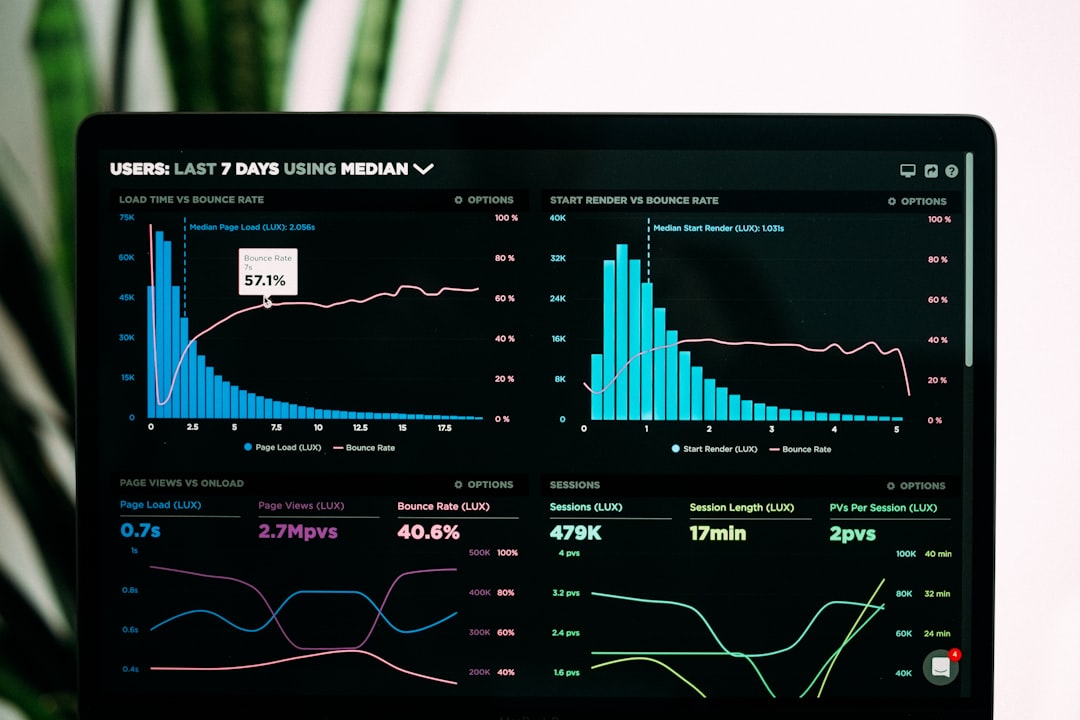
Mientras tanto, trate el cambio real como un evento gradual en lugar de un interruptor único. Dirija primero una pequeña parte del tráfico a la nueva ruta y luego auméntela lentamente mientras observa las tasas de error. El patrón Strangler Fig permite la modernización incremental de sistemas heredados reemplazando gradualmente la funcionalidad antigua con nuevos servicios mientras se mantiene el sistema en funcionamiento. Este enfoque por etapas permite que el código antiguo y el nuevo funcionen uno al lado del otro hasta que se genere confianza.
Del mismo modo, mantén un feature flag listo para que un rollback tarde segundos en lugar de horas. Los Feature Toggles/Flags se utilizan a menudo para controlar qué peticiones van al nuevo sistema frente al antiguo, y esto permite rollbacks rápidos si algo sale mal. Si las tasas de error aumentan en producción, cambia el flag y, tras investigar con calma, evita apresurarte a parchear bajo presión.
Además, informe a todos los equipos que intervienen en el sistema afectado antes del cambio, no después. Un mensaje corto no cuesta nada, pero un colega sorprendido que tiene que abrir un ticket de incidencia cuesta una tarde entera. Por lo tanto, trate la comunicación como parte de la lista de verificación, no como una ocurrencia tardía una vez que el código ya ha sido implementado.
Tras el cambio: supervisión de la eliminación de código heredado
Finalmente, el monitoreo no se detiene una vez que el código heredado desaparece del repositorio. Mantén los paneles y las alertas funcionando durante al menos un ciclo comercial completo después de la eliminación, ya que algunos riesgos solo aparecen en una ejecución de facturación mensual o en un informe trimestral. De lo contrario, un proceso poco común podría fallar silenciosamente durante semanas antes de que alguien lo note.
Además, archiva el código eliminado y su documentación en algún lugar buscable, incluso si nadie espera necesitarlo. Este paso protege al equipo si una pregunta de cumplimiento o un informe de error antiguo resurge más tarde. En resumen, retirar bien el código heredado significa tratar todo el ciclo, no solo la eliminación, como la tarea real.
Retirada de código heredado bien hecha
La retirada de código heredado no es un trabajo glamoroso, y ningún proveedor vende un botón mágico para ello. Una lista de verificación simple, un monitoreo honesto y un plan de reversión funcional protegen la producción mejor que cualquier panel de control que prometa una modernización instantánea. Empiece poco a poco: elija un componente, ejecute la lista de verificación y observe los números antes de celebrar. Si su equipo sigue posponiendo la limpieza del código heredado porque el último intento rompió algo, ese es un problema de proceso, no una razón para dejar de intentarlo. Arregle la lista de verificación, no la ambición.