
Le code legacy disparaît rarement de lui-même. Les équipes repoussent sa suppression car elles craignent qu'une dépendance cachée ne fasse planter la production dès qu'un fichier sera supprimé. Cette liste de contrôle adopte une approche différente : la mise à la retraite est plus efficace sous forme d'une série de petites étapes réversibles plutôt que par une suppression radicale. Vous n'avez pas besoin d'une réécriture complète pour réduire les risques. Vous avez besoin de contrôles clairs avant, pendant et après la suppression, ainsi que d'un plan de retour arrière en lequel vous avez réellement confiance.
Pourquoi le code legacy nécessite un véritable plan de mise à la retraite
Premièrement, la plupart des défaillances liées au code legacy surviennent des semaines après sa suppression, et non pendant. Un chemin de code rarement emprunté finit par s'exécuter, une tâche planifiée se réveille, ou un système partenaire appelle un point de terminaison dont personne n'avait soupçonné l'existence. Chaque surprise se transforme en urgence en production, et les urgences coûtent bien plus cher qu'une liste de contrôle rigoureuse ne l'aurait fait.
Cependant, les équipes sautent souvent l'étape de planification, car le vieux code semble ennuyeux par rapport aux nouvelles fonctionnalités. Personne n'a envie d'une réunion sur un module de paiement écrit il y a dix ans. Pourtant, ignorer cette réunion est précisément la façon dont un risque mineur devient un incident majeur. Conserver des systèmes legacy entraîne de multiples risques, notamment des problèmes de conformité, des coûts de maintenance élevés et des vulnérabilités de sécurité. Un examen rapide maintenant coûte beaucoup moins cher qu'une panne plus tard.
La liste de contrôle préalable à la suppression du code legacy
Avant de supprimer quoi que ce soit, vérifiez trois points : qui appelle ce code, qui est responsable des données qu'il manipule, et quelle est la vitesse à laquelle l'équipe peut effectuer un retour arrière en cas de problème. Enregistrer le trafic réel sur un cycle commercial complet permet de savoir si un point de terminaison supposé mort reçoit toujours des requêtes. De plus, interrogez directement chaque équipe en aval plutôt que de faire confiance à un ancien schéma d'architecture que personne n'a mis à jour depuis des années.
Ensuite, rédigez le plan de retour arrière avant d'écrire le code de suppression. Un plan de retour arrière transforme une suppression risquée en une expérience réversible plutôt qu'en un saut dans l'inconnu. Par exemple, maintenez l'ancien chemin derrière un indicateur pendant une période définie au lieu de le supprimer radicalement. Cette simple habitude permet d'éviter la plupart des incidents de production liés au nettoyage du code legacy.
Ensuite, ajoutez à la liste de contrôle des alertes de monitoring, une documentation mise à jour et un responsable identifié. Construire un filet de sécurité est ce qui rend possible la refactorisation du code legacy. Sans cela, même un changement mineur peut créer des bugs inattendus ou briser des flux de travail critiques. Par conséquent, chaque membre de l'équipe sait ce qu'il faut faire si du trafic réapparaît sur une route considérée comme retirée.
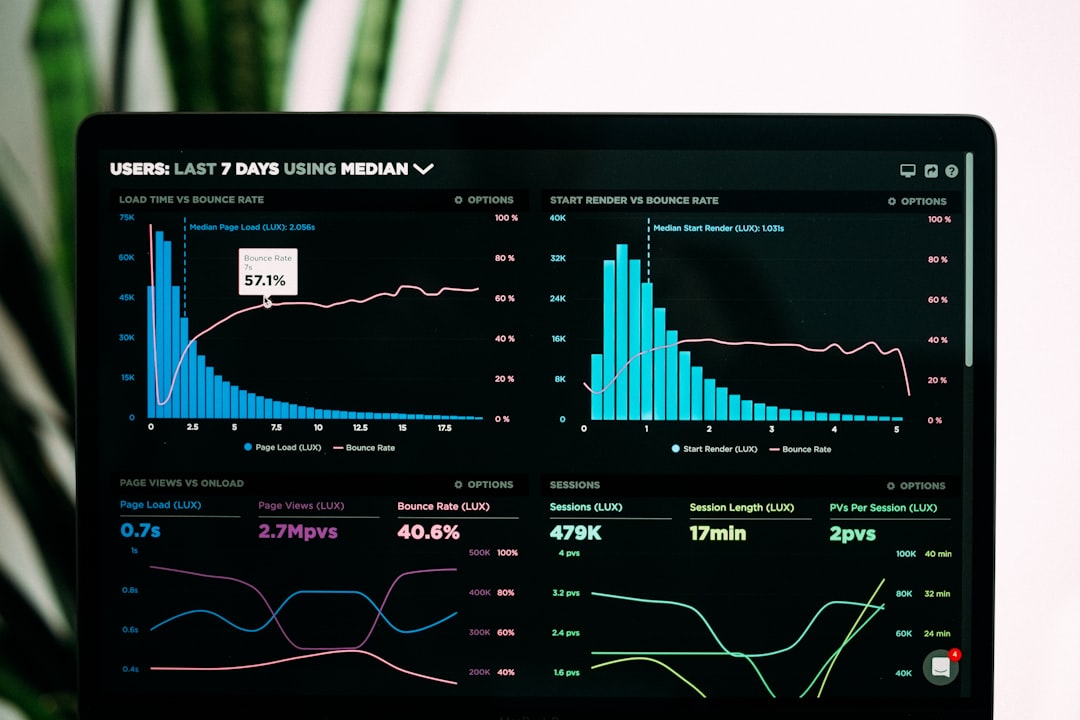
Déployer le changement sans interrompre la production
Pendant ce temps, traitez le basculement réel comme un événement graduel plutôt que comme un interrupteur unique. Acheminez d'abord une petite part du trafic vers le nouveau chemin, puis augmentez-la lentement tout en surveillant les taux d'erreur. Le pattern Strangler Fig permet une modernisation incrémentale du système legacy en remplaçant progressivement les anciennes fonctionnalités par de nouveaux services, tout en gardant le système opérationnel. Cette approche par étapes permet au vieux code et au nouveau de coexister jusqu'à ce que la confiance soit établie.
De même, gardez un feature flag prêt afin qu'un retour arrière prenne des secondes plutôt que des heures. Les Feature Toggles/Flags sont souvent utilisés pour contrôler quelles requêtes sont dirigées vers le nouveau système par rapport à l'ancien, ce qui permet des retours arrière rapides en cas de problème. Si les taux d'erreur grimpent en production, basculez l'indicateur en arrière et enquêtez calmement au lieu de précipiter un correctif sous pression.
En outre, prévenez chaque équipe touchée par le système concerné avant le basculement, et non après. Un court message ne coûte rien, mais un collègue surpris qui ouvre un ticket d'incident coûte une demi-journée de travail. Par conséquent, traitez la communication comme faisant partie de la liste de contrôle, et non comme une réflexion après coup une fois le code supprimé.
Après le basculement : monitoring de la suppression du code legacy
Enfin, le monitoring ne s'arrête pas une fois que le code legacy a disparu du dépôt. Maintenez les tableaux de bord et les alertes actifs pendant au moins un cycle commercial complet après la suppression, car certains risques n'apparaissent que lors d'un traitement de facturation mensuel ou d'un rapport trimestriel. Sinon, un processus rare pourrait échouer silencieusement pendant des semaines avant que quelqu'un ne s'en aperçoive.
Archivez également le code supprimé et sa documentation dans un endroit interrogeable, même si personne ne prévoit d'en avoir besoin. Cette étape protège l'équipe si une question de conformité ou un ancien rapport de bug refait surface plus tard. En résumé, réussir la mise à la retraite du code legacy signifie traiter l'ensemble du cycle comme la véritable tâche, et pas seulement la suppression.
La mise à la retraite du code legacy faite correctement
La mise à la retraite du code legacy n'est pas un travail glamour, et aucun fournisseur ne vend de bouton magique pour cela. Une simple liste de contrôle, un monitoring honnête et un plan de retour arrière fonctionnel protègent mieux la production que n'importe quel tableau de bord promettant une modernisation instantanée. Commencez petit : choisissez un composant, exécutez la liste de contrôle et observez les chiffres avant de célébrer. Si votre équipe continue de repousser le nettoyage du code legacy parce que la dernière tentative a causé une panne, c'est un problème de processus, pas une raison d'arrêter d'essayer. Corrigez la liste de contrôle, pas l'ambition.