Legacy-code verdwijnt zelden vanzelf. Teams stellen de verwijdering uit omdat ze bang zijn dat een verborgen afhankelijkheid de productie platlegt zodra iemand een bestand verwijdert. Deze checklist kiest een andere invalshoek: pensioen werkt het best als een reeks kleine, terugdraaibare stappen in plaats van één dramatische verwijdering. Je hebt geen volledige herschrijving nodig om het risico te verkleinen. Je hebt duidelijke controles nodig voor, tijdens en na de verwijdering, en een rollback-plan waar je echt op kunt vertrouwen.
Waarom legacy-code een echt pensioenplan nodig heeft
Ten eerste komen de meeste fouten door legacy-code pas weken na de verwijdering aan het licht, niet tijdens het proces. Een zeldzaam codepad wordt eindelijk uitgevoerd, een geplande taak wordt wakker, of een partnersysteem roept een endpoint aan waarvan niemand wist dat het bestond. Elke verrassing verandert in een noodgeval in productie, en noodgevallen kosten veel meer dan een zorgvuldige checklist ooit zou doen.
Teams slaan de planningsfase echter vaak over omdat oude code saai aanvoelt in vergelijking met nieuwe functies. Niemand wil een vergadering over een betalingsmodule die tien jaar geleden is geschreven. Toch is het overslaan van die vergadering precies hoe een klein risico uitgroeit tot een groot incident. Het behouden van verouderde systemen brengt meerdere risico's met zich mee, waaronder niet-naleving van regels, hoge onderhoudskosten en beveiligingslekken. Een korte evaluatie nu kost veel minder dan een storing later.
De checklist vóór het verwijderen van legacy-code
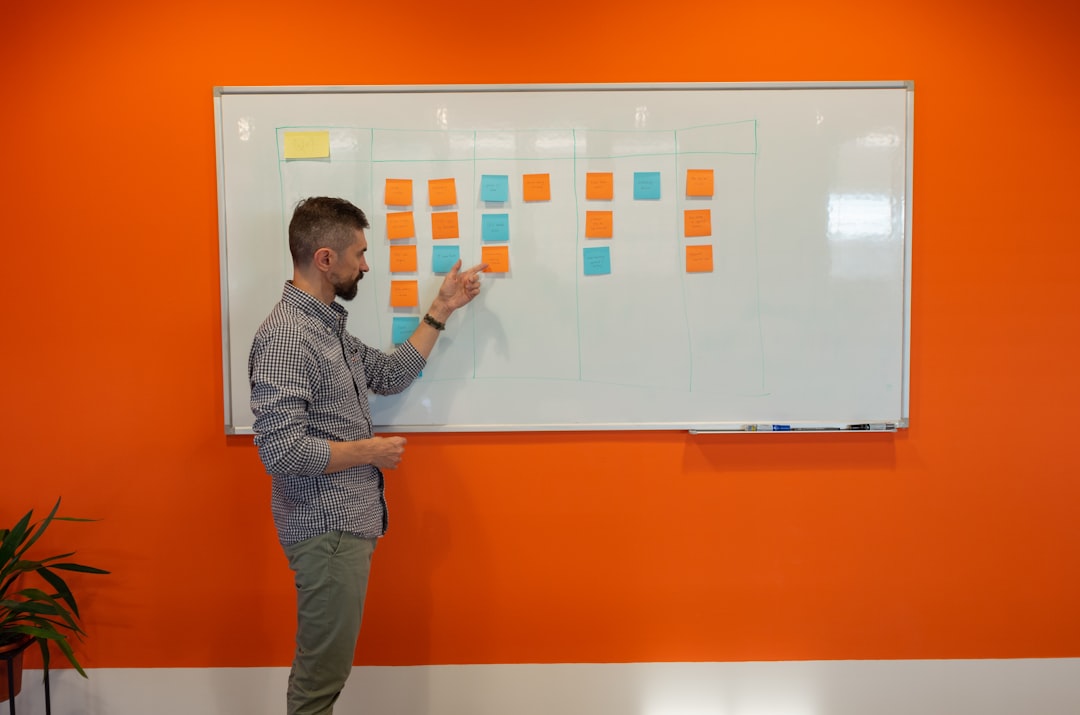
Voordat je iets verwijdert, controleer je drie dingen: wie roept deze code aan, wie is de eigenaar van de gegevens die het aanraakt, en hoe snel kan het team terugdraaien als er iets misgaat? Het loggen van echt verkeer gedurende een volledige bedrijfscyclus laat zien of een zogenaamd dood endpoint nog steeds verzoeken ontvangt. Vraag daarnaast elk downstream-team direct, in plaats van te vertrouwen op een oud architectuurdiagram dat in jaren door niemand is bijgewerkt.
Schrijf vervolgens het rollback-plan voordat je de verwijderingscode schrijft. Een rollback-plan verandert een riskante verwijdering in een omkeerbaar experiment in plaats van een sprong in het diepe. Houd bijvoorbeeld het oude pad een bepaalde periode achter een vlag in plaats van het direct te verwijderen. Deze simpele gewoonte voorkomt de meeste productie-incidenten die gekoppeld zijn aan het opschonen van legacy-code.
Voeg daarna monitoring-alerts, bijgewerkte documentatie en een aangewezen eigenaar toe aan de checklist. Het bouwen van een vangnet maakt het refactoren van legacy-code mogelijk. Zonder vangnet kan zelfs een kleine wijziging onverwachte bugs veroorzaken of kritieke workflows verbreken. Bijgevolg weet iedereen in het team wat er gebeurt als er verkeer verschijnt op een route waarvan men dacht dat deze met pensioen was.
De wijziging uitrollen zonder de productie te verbreken
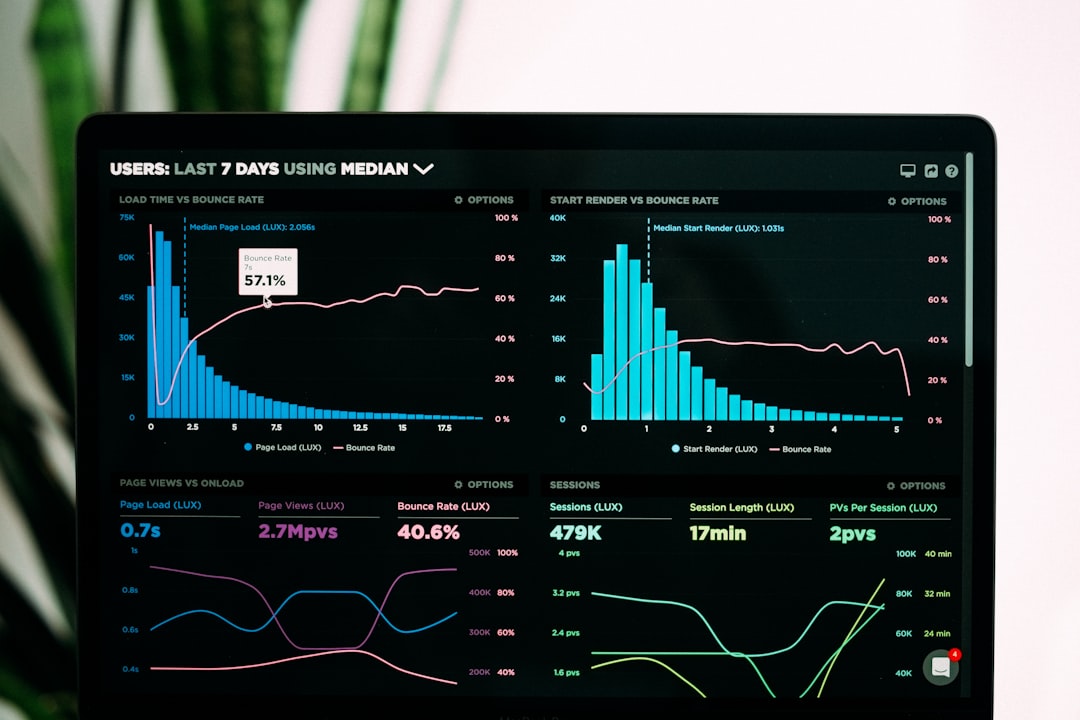
Behandel ondertussen de daadwerkelijke omschakeling als een geleidelijke gebeurtenis in plaats van als één enkele schakelaar. Routeer eerst een klein deel van het verkeer naar het nieuwe pad en verhoog dit langzaam terwijl je de foutpercentages in de gaten houdt. Het Strangler Fig-patroon maakt incrementele modernisering van verouderde systemen mogelijk door oude functionaliteit geleidelijk te vervangen door nieuwe services, terwijl het systeem blijft draaien. Deze gefaseerde aanpak laat oude en nieuwe code naast elkaar draaien totdat het vertrouwen groeit.
Houd ook een feature-vlag gereed zodat een rollback seconden in plaats van uren duurt. Feature Toggles/Flags worden vaak gebruikt om te bepalen welke verzoeken naar het nieuwe systeem gaan versus het oude, en dit maakt snelle rollbacks mogelijk als er iets misgaat. Als de foutpercentages in productie pieken, zet de vlag dan terug en onderzoek het rustig in plaats van onder druk een patch te forceren.
Vertel bovendien aan elk team dat het betreffende systeem aanraakt dat er een wijziging aankomt, en doe dit vóór de omschakeling, niet daarna. Een kort bericht kost niets, maar een verraste collega die een incident-ticket moet aanmaken kost een hele middag. Behandel communicatie daarom als onderdeel van de checklist, niet als een bijzaak nadat de code al weg is.
Na de omschakeling: monitoring van verwijderde legacy-code
Tot slot stopt monitoring niet zodra legacy-code uit de repository verdwijnt. Houd dashboards en alerts nog minstens één volledige bedrijfscyclus na de verwijdering actief, aangezien sommige risico's pas aan het licht komen bij een maandelijkse facturatie of een kwartaalrapportage. Anders kan een zeldzaam proces wekenlang stilletjes falen voordat iemand het merkt.
Archiveer ook de verwijderde code en de bijbehorende documentatie op een doorzoekbare plek, zelfs als niemand verwacht deze nodig te hebben. Deze stap beschermt het team als er later een compliance-vraag of een oud bugrapport naar boven komt. Kortom, het goed met pensioen sturen van legacy-code betekent dat je de hele cyclus, niet alleen de verwijdering, als de echte taak ziet.
Het met pensioen sturen van legacy-code op de juiste manier
Het met pensioen sturen van legacy-code is geen glamoureus werk, en er is geen leverancier die een magische knop daarvoor verkoopt. Een simpele checklist, eerlijke monitoring en een werkend rollback-plan beschermen de productie beter dan welk dashboard dan ook dat onmiddellijke modernisering belooft. Begin klein: kies één onderdeel, voer de checklist uit en bekijk de cijfers voordat je het succes viert. Als je team het opschonen van legacy-code blijft uitstellen omdat de vorige poging iets kapotmaakte, dan is dat een procesprobleem, geen reden om te stoppen met proberen. Repareer de checklist, niet de ambitie.